세레브라스(Cerebras)가 2026년 5월 나스닥에 상장한 뒤, 첫날부터 공모가를 크게 웃도는 흐름이 뉴스에 많이 잡혔습니다.
티커는 CBRS이고, 공모가는 주당 185달러로 보도·공시됩니다.
관심은 주가 숫자보다, 이 회사가 내세우는 ‘웨이퍼 한 장≈칩 한 장’이 엔비디아 GPU를 여러 장 묶는 방식과 뭐가 다른지 입니다.
상장 당일(2026-05-14) 시초가·고가·종가는 보도마다 세부 표기가 조금 다르지만, CNBC 등에서는 시초가 약 350달러, 고가 약 386달러, 종가 약 311달러(공모가 대비 큰 폭 상승)로 정리됩니다. 이후 9월경 시세 사이트 기준으로는 200달러대 근처·시총 약 500억달러대로 읽히는 구간도 있습니다. 시세는 계속 바뀌니, 여기서는 상장 직후 관심이 컸다는 배경만 잡고 제품 이야기로 넘어가겠습니다.

📷 사진 1 · Cerebras CS 시스템 실사(전면 그릴) · 출처: Cerebras 공식
웨이퍼스케일이 실제로 의미하는 것
일반 GPU는 300mm 웨이퍼 위에 작은 칩(다이)을 여러 개 만들고, 잘라서 패키지로 씁니다. 세레브라스의 WSE(Wafer-Scale Engine)는 반대로, 웨이퍼에서 쓸 수 있는 큰 정사각 영역을 잘라내지 않고 하나의 프로세서로 쓰겠다는 설계입니다. 회사 표현으로는 “웨이퍼스케일 프로세서”입니다.
WSE-3(CS-3에 탑재) 회사 자료 기준 대략치는 이렇습니다. TSMC 5nm, 실리콘 면적 약 46,225 mm², 트랜지스터 약 4조, AI 코어 약 90만, 온칩 SRAM 44GB. 회사는 “가장 큰 GPU” 대비 면적이 약 57배(814 mm² vs 46,225 mm²)라고 적습니다. 이 비교는 회사 자료의 GPU 기준이니, 세대·모델이 바뀌면 숫자도 바뀝니다.
다만 Hot Chips 등 기술 설명에서는, 안쪽에 레티클(노광 단위)급 영역이 여러 개 온웨이퍼로 이어진 형태로 읽히는 부분도 있습니다. “실리콘 덩어리가 물리적으로 칼질 없이 하나”와 “내부는 구역이 이어진 웨이퍼스케일 칩”은 결이 다릅니다. 블로그에서는 연결된 웨이퍼스케일 칩 정도로 두는 편이 안전합니다.
메모리도 포인트입니다. GPU가 HBM을 칩 옆에 두는 그림과 달리, WSE 쪽 주력 설명은 온웨이퍼 SRAM과 칩 안 배선(패브릭)으로 대역·지연을 가져가려는 쪽에 가깝습니다.
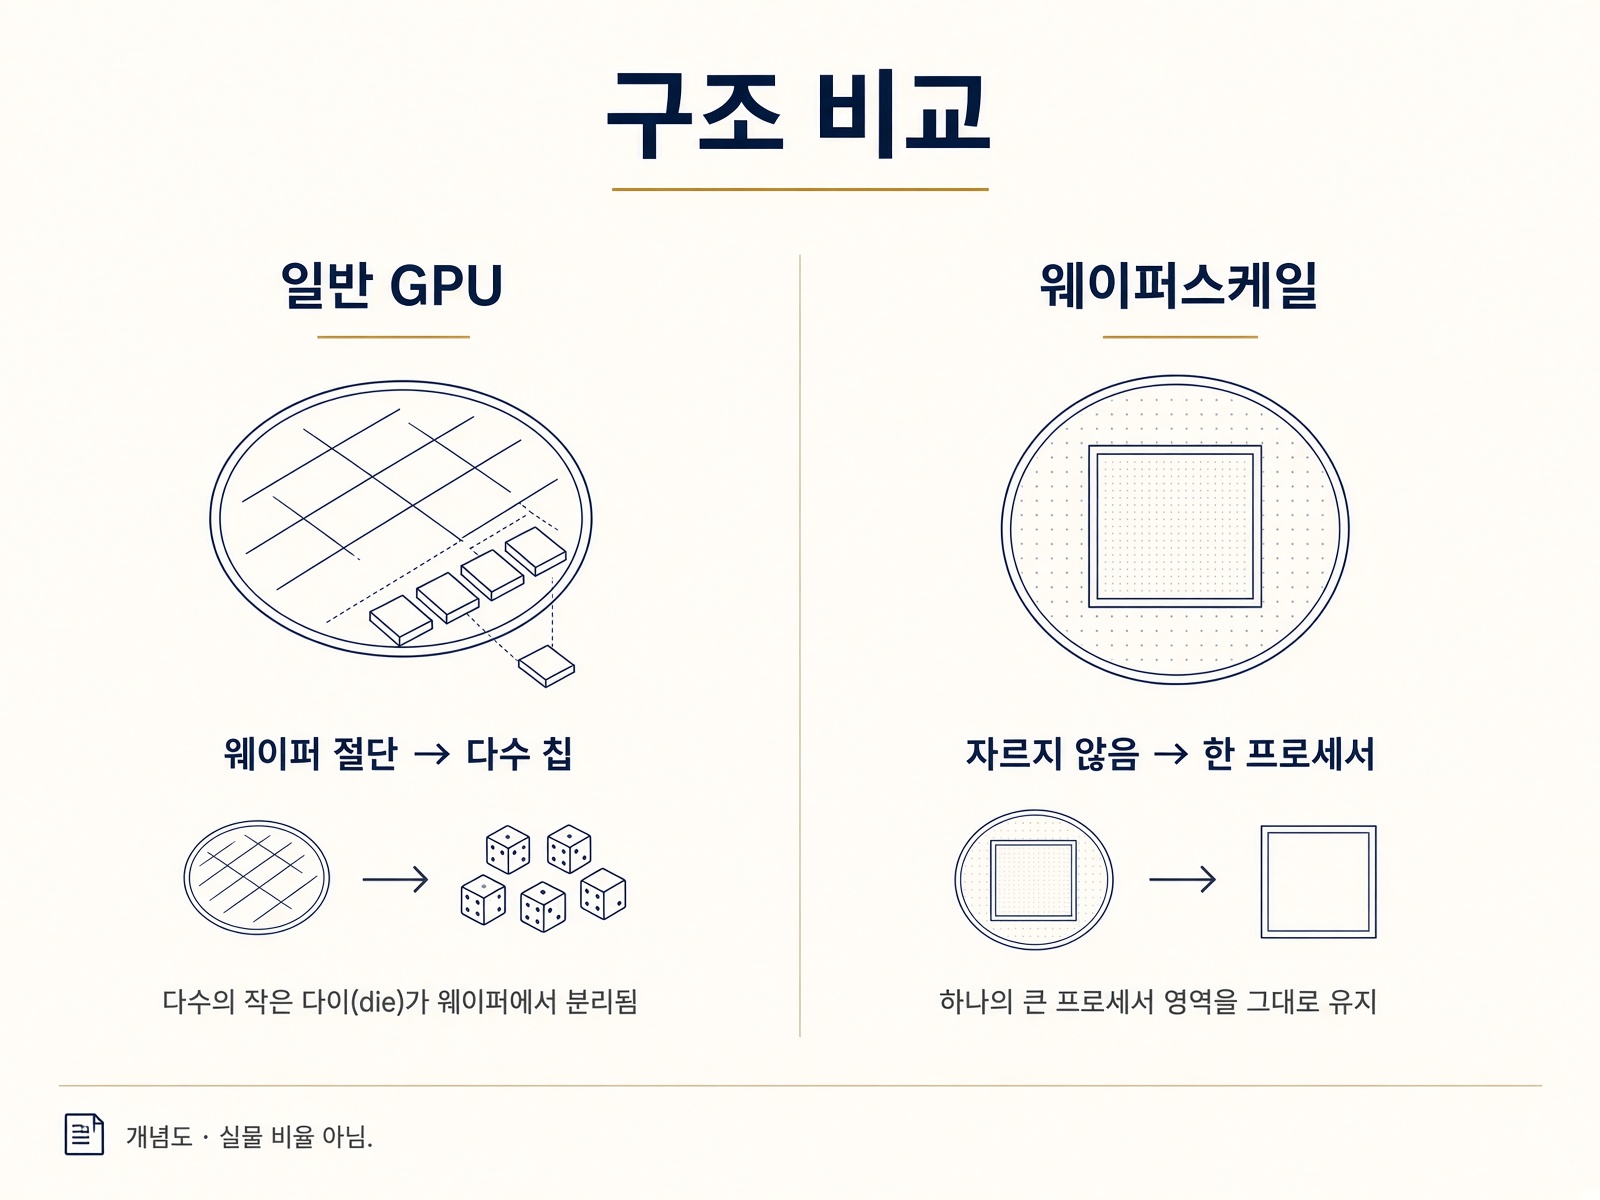
📷 사진 2 · 웨이퍼 vs 다수 GPU 구조 비교 인포(생성컷)
엔비디아 GPU 클러스터와는 ‘묶는 방식’이 다릅니다
엔비디아 쪽 흔한 그림은 GPU를 여러 장 두고, NVLink·InfiniBand 같은 칩 밖 네트워크로 이어 학습·추론을 키우는 방식입니다. 세레브라스는 그 연결의 상당 부분을 칩(웨이퍼) 안으로 끌어오겠다는 쪽에 가깝습니다.
| Cerebras (WSE/CS-3) | 일반 NVIDIA GPU 클러스터 | |
|---|---|---|
| 구조 | 단일(또는 소수) 웨이퍼스케일 칩 + 시스템 | 다수 GPU + 인터커넥트 |
| 데이터 이동 | 온칩 패브릭·SRAM 중심 | 칩↔HBM + GPU↔GPU 네트워크 |
| 소프트웨어 | Cerebras 스택 | CUDA 생태계가 사실상 표준 |
| 자주 거론되는 강점 | 저지연 추론(토큰 생성 등)·온칩 대역 | 학습·범용·생태계·공급 |
회사 자료의 “추론 최대 약 15배”, “면적 약 57배” 같은 문구는 벤치 조건·비교 GPU가 묶인 주장입니다. “회사 자료에 따르면”으로만 읽고, 독립 검증된 만능 수치처럼 쓰지 않는 편이 맞습니다. OpenAI는 2026년 1월 제휴를 공개하면서, 저지연 추론용 컴퓨트 포트폴리오의 한 축으로 표현했습니다. GPU를 밀어내는 대체가 아니라 병행·보완 프레임에 가깝습니다. AWS도 2026년 3월 CS-3를 클라우드 추론 경로에 넣는 협력을 공개했고, prefill과 decode를 나누어 쓰는 식으로 설명합니다.
📷 사진 3 · Cerebras 랙형 시스템 실사 · 출처: Cerebras 공식
한계도 같이 보는 편이 낫습니다
공개 범위에서 자주 나오는 제약은 분명합니다. CUDA급 소프트웨어 생태계·범용성에서는 엔비디아 쪽이 압도적으로 넓고, 과거 IPO 과정에서 고객 집중(예: UAE·G42 비중)이 리스크로 거론됐다는 보도도 있습니다. Meta Llama API 초고속 추론, Hugging Face, IBM, Perplexity·Mistral 등 이름이 보도에 더 붙지만, 계약 규모는 건마다 다릅니다.
한국 독자 기준으로는 한 줄만 명확히 하겠습니다. 삼성·SK하이닉스·국내 파운드리와 Cerebras의 직접 공급·공동개발 공개 근거는 확인되지 않습니다. 공개된 제조 파트너는 TSMC 쪽이고, 주메모리 설명이 온칩 SRAM 중심이라 HBM 수요 스토리와도 억지로 잇기 어렵습니다.
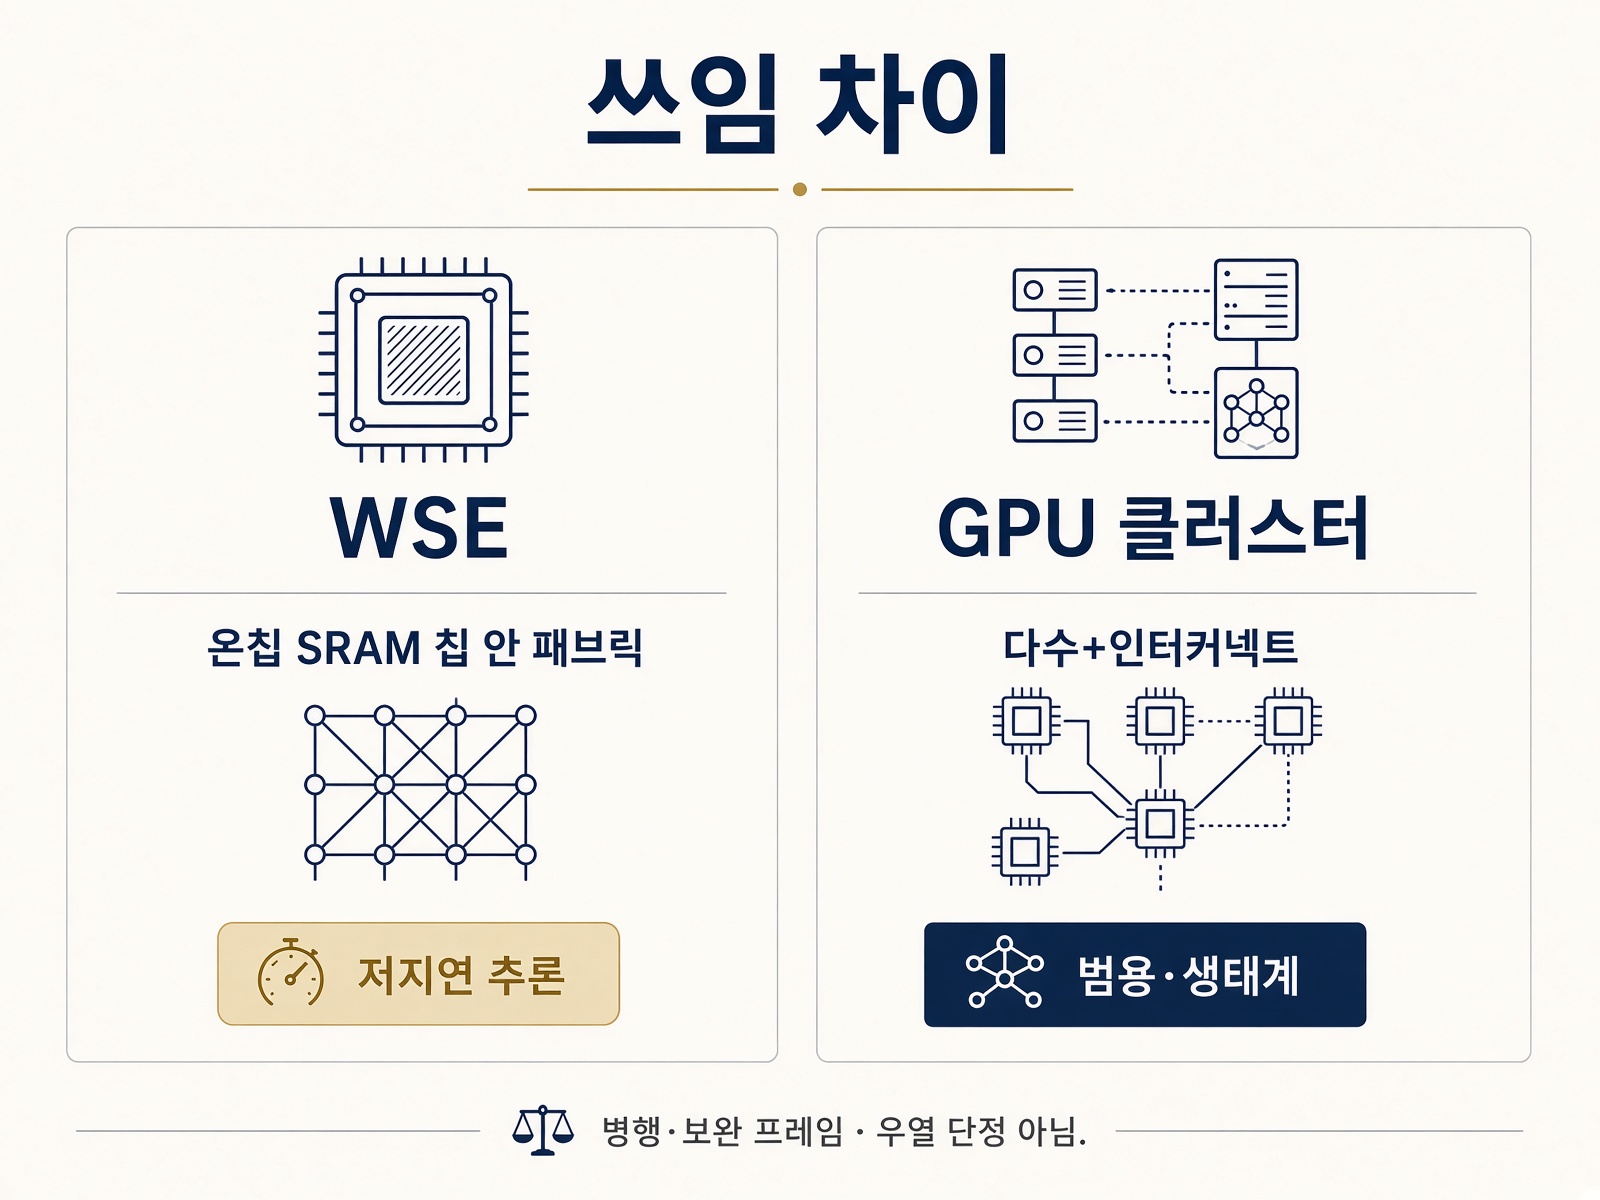
📷 사진 4 · WSE vs GPU 클러스터·쓰임 차이 한눈 인포(생성컷)
정리하면, 뉴스의 급등은 “새 상장·큰 관심” 신호이고, 제품 핵심은 웨이퍼를 잘라 쓰는 GPU 다수 묶음이 아니라 큰 웨이퍼 영역을 한 프로세서로 쓰는 구조에 있습니다. 어디에 더 맞는지는 학습·범용보다 저지연 추론 같은 쓰임에서 거론되는 편이고, 생태계·고객 분산·검증 수치는 아직 따로 봐야 합니다.
다음 뉴스를 볼 때 어떤 문장을 더 경계하시나요. ‘GPU 대체’인지, 아니면 ‘추론 포트폴리오에 추가’인지요?